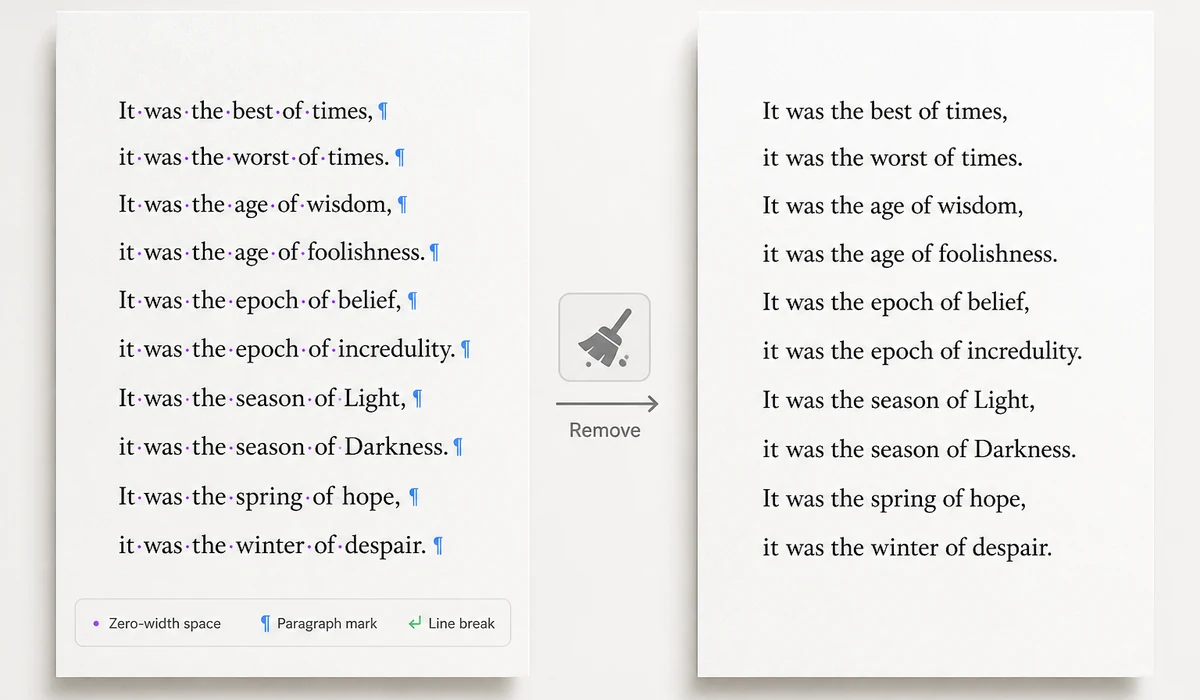
从输入到结果,一眼看懂
选择文件、执行处理、检查并导出,全程在浏览器本地完成。
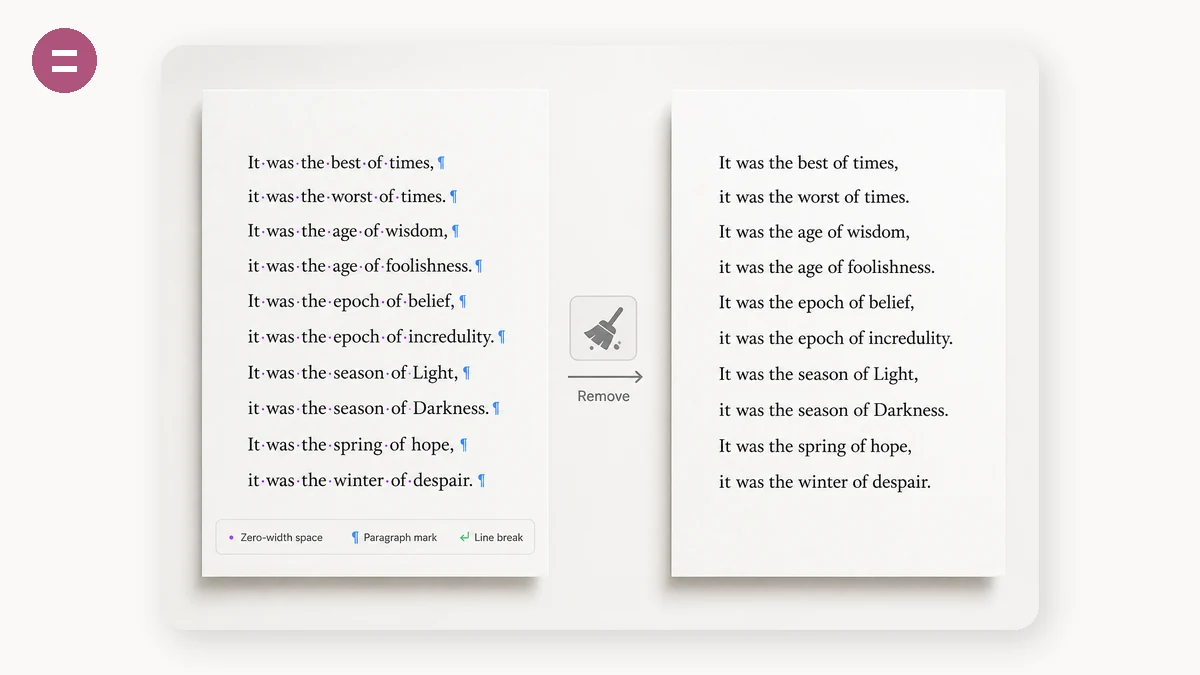
文本里可以藏东西。零宽空格、零宽连接符、标签字符这些码点在屏幕上不占宽度也不显示,却实实在在存在于字节里——它们能被用来编码一串隐藏信息,也可能只是你从网页或 PDF 复制时顺手带出来的垃圾。无论哪种来源,它们都会让代码报错、让表单校验失败、让搜索匹配不到,而你在编辑器里什么都看不见。
这个工具把它们标出来给你看。每个可疑字符都会显示码点、标准名称、出现次数和位置,可视化预览会把原本不可见的字符渲染成彩色标记,你可以直接看到它们藏在哪一句里。
有一点和多数同类工具不同:我们不会无脑删除所有零宽字符。👨👩👧 靠零宽连接符把三个人拼成一家人,❤️ 靠变体选择符才显示成红色,波斯语和印地语靠零宽非连接符断字——这些位置的字符是内容的一部分,删了就是改坏内容。工具会识别上下文并默认保留它们,同时明确标出来,你想强制删除也可以。
怎么用
放入文本
直接粘贴,或者点「从剪贴板粘贴」。输入的同时就会开始扫描。
看清楚发现了什么
表格列出每种可疑字符的码点、名称、数量和位置;可视化预览把它们标在原文里。标为保留的是内容需要的,不会被删。
移除并取走
确认选项后点「移除AI水印」,结果可以直接复制,也可以下载成 .txt。明细里会列出到底删了什么、替换了什么。
常见问题
移除之后能通过 AI 检测吗?
这两件事关系不大。AI 检测器主要看文风的统计特征,不看隐形字符。清掉隐形字符能解决的是“文件里有不该有的东西”,不是“这段话像不像 AI 写的”。真正的统计水印我们无法处理,也不会假装能处理。
为什么有些字符被标成保留?
因为删掉会改坏内容。emoji 组合、阿拉伯语、波斯语、印地语的正确显示都依赖特定位置的零宽字符。工具会判断上下文,只有在它们确实“在干活”时才保留。关掉「保护 emoji 与连字」就会全部删除。
文本会被发送出去吗?
不会。整个页面加载完之后即使断网也能正常用,没有任何请求会带走你的文字。
「同形字母还原」是做什么的?
有人会用西里尔字母 а е о 冒充拉丁字母 a e o,看起来一模一样但字节不同,可以绕过关键词过滤,也会让搜索失效。这个选项把它们换回拉丁字母。它默认关闭,因为如果你的文本本来就是俄语,开了会直接毁掉。
NFKC 规范化会改变什么?
会把 ①、fi、㈱、全角数字这类兼容字符展开成基本形式。属于破坏性操作,外观会变,所以默认关闭。
相关教程
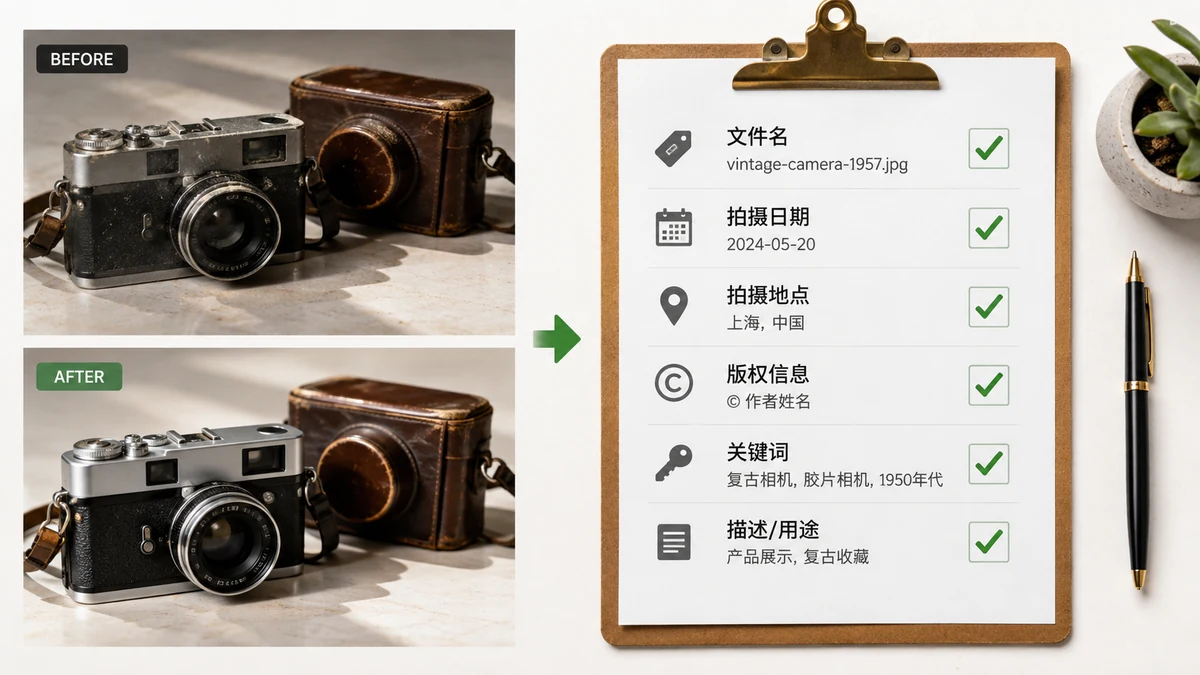
发布任何文件之前,值得花两分钟做的元数据自检
按场景组织的元数据清理清单:投简历、客户交付、社交平台传图、开源提交、新闻稿、投标、双盲投稿。每个场景讲清会泄露什么、从哪泄露、怎么查、怎么清,附一套通用三步法。
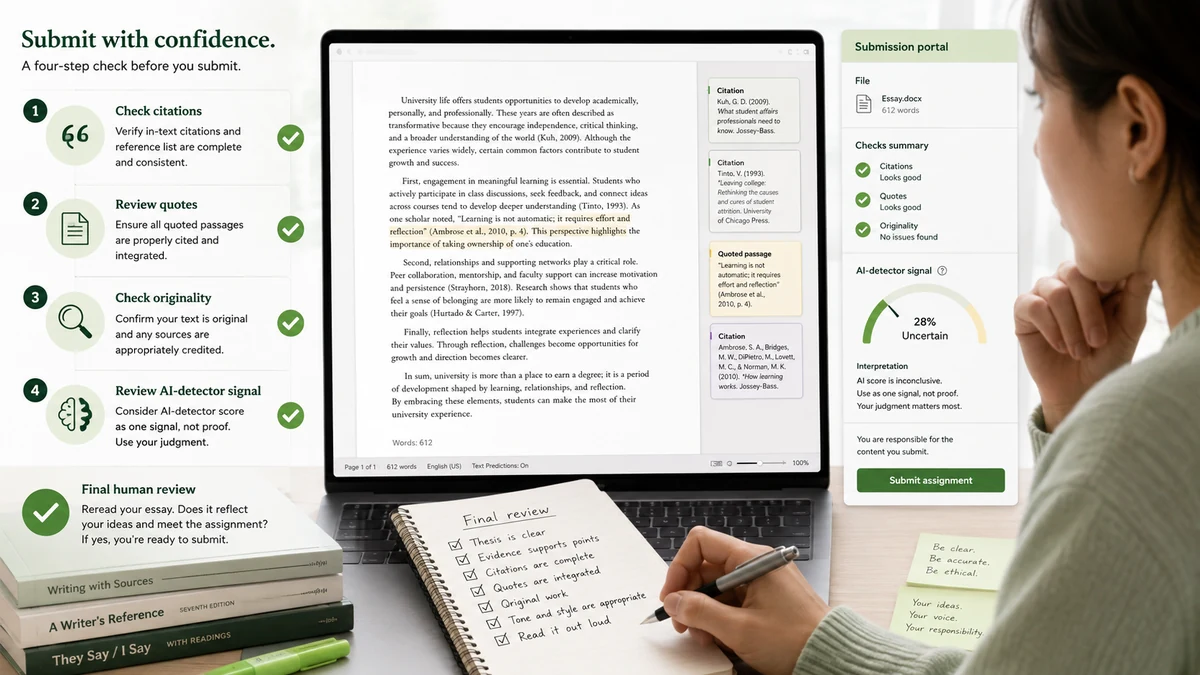
论文、作业被判 AI 率高?先排查这几个技术问题
自己写的东西被判 AI 率高,除了文风还有几个技术原因:粘贴带进来的隐形字符、对不上的文档元数据、润色工具留下的痕迹。一份可以照着走的排查清单,以及为自己留证据的正确做法。
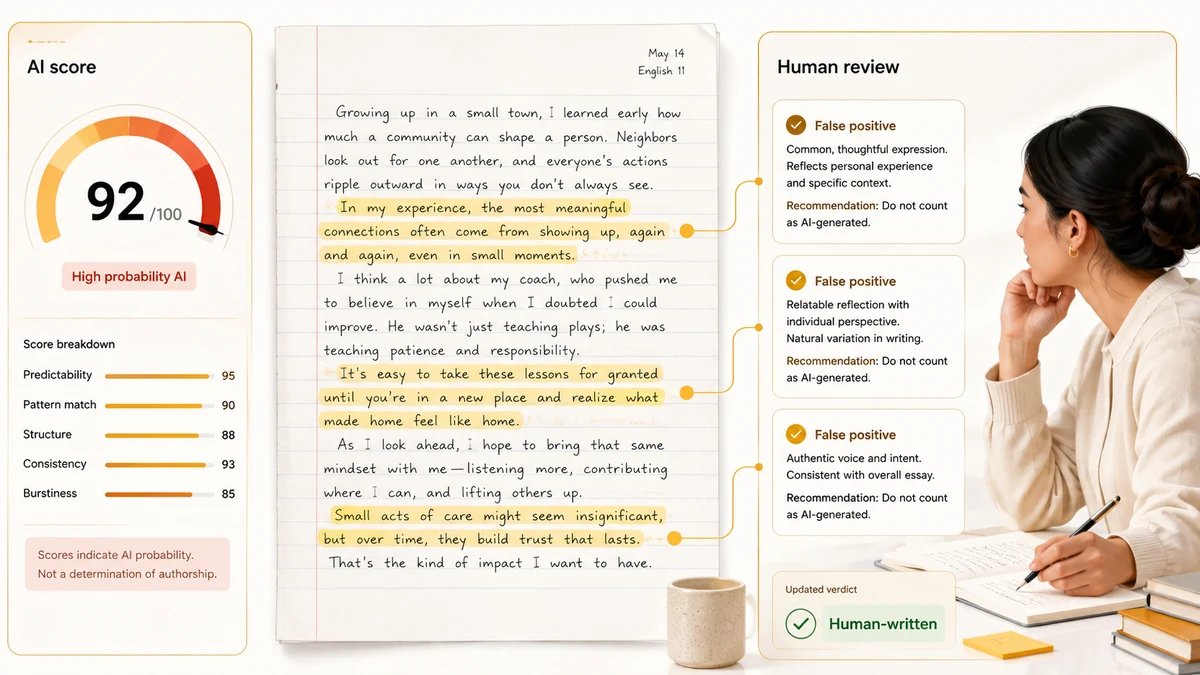
AI 检测器为什么老是判错:原理与它的真实局限
AI 检测器靠困惑度和突发性做统计猜测,非母语写作者、技术文档、模板化写作被误判的概率天然更高。本文讲清两类检测原理、误判为什么是系统性的,以及它为何不该作为处罚依据。
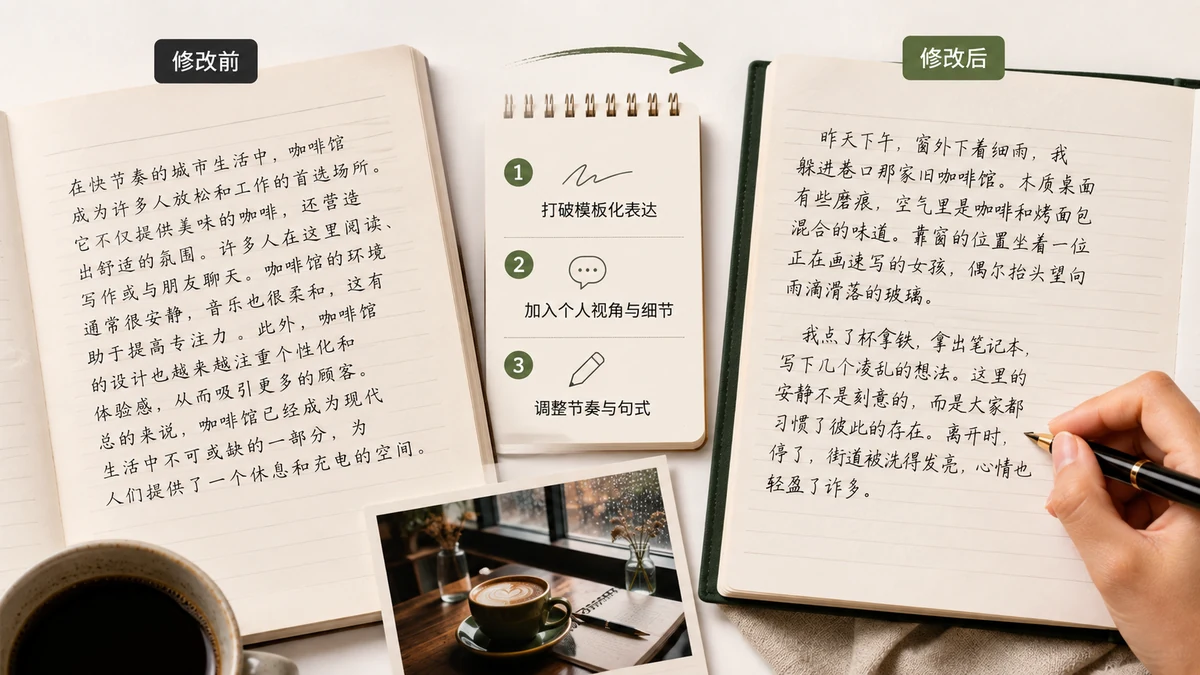
去 AI 味文案实操:为什么"改写"和"去水印"是两件事
AI 味是文风问题,统计水印是数学问题,两者的解法完全不同。本文列出中文 AI 写作的典型特征和真正有效的改法,并说清改写对统计水印到底能做到什么、做不到什么。